Ce blog a été rédigé en collaboration avec Fan Bu, Jason Mackay, Borya Sobolev, Dev Khanolkar, Ali Dabir, Puneet Kamal, Li Zhang et Lei Jin.
« Tout est un dossier » ; certains sont des bases de données
Introduction
Les données machine sous-tendent l’observabilité et le diagnostic dans les systèmes informatiques modernes, notamment les journaux, les métriques, les traces de télémétrie, les instantanés de configuration et les charges utiles de réponse API. En pratique, ces données sont intégrées dans des invites pour former une composition entrelacée d’instructions en langage naturel et de grandes charges utiles générées par la machine, généralement représentées sous forme de blobs JSON ou de littéraux Python/AST. Bien que les grands modèles de langage excellent dans le raisonnement du texte et du code, ils ont souvent du mal avec les séquences générées par la machine, en particulier lorsque celles-ci sont longues, profondément imbriquées et dominées par une structure répétitive.
Nous observons à plusieurs reprises trois modes de défaillance :
Explosion de jetons due à la verbosité : les clés imbriquées et les schémas répétés dominent la fenêtre contextuelle, fragmentant les données. Pourriture du contexte : le modèle manque « l’aiguille » cachée à l’intérieur des grosses charges utiles et s’écarte de l’instruction. Faiblesse dans le raisonnement de séquences numériques/catégorielles : les séquences longues obscurcissent les modèles tels que les anomalies, les tendances et les relations entre entités. Le goulot d’étranglement ne concerne pas simplement la longueur des entrées. Les données machine nécessitent plutôt une transformation structurelle et une amélioration du signal afin que les mêmes informations soient présentées dans des représentations alignées sur les points forts d’un modèle.
« Tout est un dossier » ; certains sont des bases de données
Anthropic a réussi à populariser l’idée selon laquelle « bash est tout ce dont vous avez besoin » pour les flux de travail agents, en particulier pour le codage d’ambiance, en exploitant pleinement le système de fichiers et les outils bash composables. Dans les contextes d’ingénierie contextuelle qui nécessitent beaucoup de données machine, nous soutenons que les principes de gestion de base de données s’appliquent : plutôt que de forcer le modèle à traiter directement les blobs bruts, les charges utiles pleine fidélité pourraient être stockées dans une banque de données, permettant à l’agent de les interroger et de générer des vues de données hybrides optimisées qui s’alignent sur les forces de raisonnement du LLM en utilisant un sous-ensemble d’instructions SQL simples.
Vues de données hybrides pour les données machine – « du SQL simple est ce dont vous avez besoin »
Ces vues hybrides s’inspirent du concept de base de données de traitement transactionnel/analytique hybride (HTAP), dans lequel différentes présentations de données servent différentes charges de travail. De même, nous maintenons des représentations hybrides de la même charge utile afin que différentes parties des données puissent être comprises plus efficacement par le LLM.
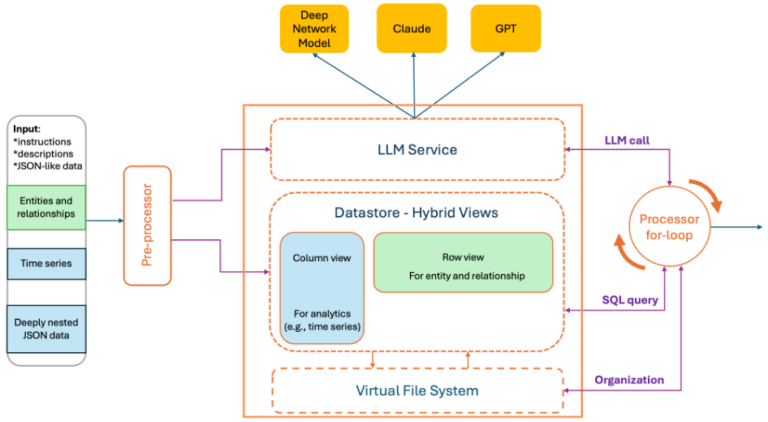
À cette fin, nous introduisons ACE (Analytics Context Engineering) pour les données machine, un cadre pour construire et gérer le contexte analytique pour les LLM. ACE combine un système de fichiers virtuel (mappage des API d’observabilité sur les fichiers et interception transparente des outils Bash pour éviter les appels MCP non évolutifs) avec la simplicité de Bash pour une organisation intuitive de haut niveau, tout en incorporant des techniques de gestion de type base de données pour permettre un contrôle précis et précis sur les entrées de données de bas niveau.
Modèle de réseau profond – ACE
ACE est utilisé dans le raisonnement du runbook Cisco AI Canvas. Il convertit les invites brutes et les charges utiles de la machine en vues hybrides dans des contextes préservant les instructions que les LLM peuvent consommer de manière fiable. ACE a été initialement conçu pour améliorer le Deep Network Model (DNM), un LLM spécialement conçu par Cisco pour les domaines de mise en réseau. Pour prendre en charge une gamme plus large de modèles LLM, ACE a ensuite été implémenté en tant que service autonome.
A haut niveau :
Un préprocesseur analyse l’invite utilisateur (comprenant le langage naturel et les blobs JSON/AST intégrés sous la forme d’une chaîne unique) et produit des vues de données hybrides ainsi que des résumés de langage facultatifs (par exemple, des statistiques ou des traces d’anomalies), le tout dans un budget de jetons spécifié. Une banque de données conserve une copie fidèle des données originales de la machine. Cela permet au contexte LLM de rester petit tout en permettant des réponses complètes. Un processeur en boucle for inspecte la sortie LLM et interroge conditionnellement la banque de données pour enrichir la réponse, produisant ainsi une réponse finale complète et structurée.
Vues orientées lignes + colonnes
Nous générons des représentations complémentaires de la même charge utile :
Vue en colonnes (centrée sur le champ). Pour les tâches d’analyse (par exemple, graphique linéaire/à barres, tendance, modèle, détection d’anomalies), nous transformons le JSON imbriqué en chemins pointillés aplatis et en séquences par champ. Cela élimine les préfixes répétés, rend les données associées contiguës et facilite le calcul par champ. Vue orientée ligne (centrée sur l’entrée). Pour prendre en charge le raisonnement relationnel (tel que les relations a-a et est-a, y compris l’appartenance à une entité et l’exploration d’associations), nous fournissons une représentation orientée lignes qui préserve les limites des enregistrements et le contexte local entre les champs. Étant donné que cette vue n’impose pas de classement inhérent aux lignes, elle permet naturellement l’application de méthodes statistiques pour classer les entrées par pertinence. Plus précisément, nous concevons un algorithme TF-IDF modifié, basé sur la pertinence des requêtes, la popularité des mots et la diversité, pour classer les lignes.
Format de rendu : nous proposons plusieurs formats pour le rendu du contenu. Le format par défaut reste JSON ; bien qu’il ne s’agisse pas toujours de la représentation la plus efficace en termes de jetons, notre expérience montre qu’elle a tendance à mieux fonctionner avec la plupart des LLM existants. De plus, nous proposons un format de rendu personnalisé inspiré du projet open source TOON et Markdown, avec plusieurs différences clés. En fonction de la structure d’imbrication du schéma, les données sont restituées soit sous forme de listes plates compactes avec des chemins de clés en pointillés, soit à l’aide d’une représentation indentée. Les deux approches aident le modèle à déduire plus efficacement les relations structurelles.
Le concept de vue hybride est bien établi dans les systèmes de bases de données, en particulier dans la distinction entre le stockage orienté lignes et celui orienté colonnes, où différentes présentations de données sont optimisées pour différentes charges de travail. Algorithmiquement, nous construisons un arbre d’analyse pour chaque blob littéral JSON/AST et parcourons l’arbre pour transformer sélectivement les nœuds à l’aide d’un algorithme avisé qui détermine si chaque composant est mieux représenté dans une vue orientée lignes ou en colonnes, tout en préservant la fidélité des instructions sous des contraintes strictes de jetons.
Principe de conception
ACE suit un principe de simplicité, privilégiant un petit ensemble d’outils génériques. Il intègre l’analyse directement dans la boucle itérative de raisonnement et d’exécution du LLM, en utilisant un sous-ensemble restreint de SQL ainsi que des outils Bash sur un système de fichiers virtuel comme mécanismes natifs de gestion et d’analyse des données. ACE donne la priorité à l’optimisation de la fenêtre contextuelle, en maximisant la capacité de raisonnement du LLM dans des invites limitées tout en conservant une copie complète des données dans une banque de données externe pour un accès basé sur des requêtes. Des opérateurs soigneusement conçus sont appliqués aux vues en colonnes, tandis que les méthodes de classement sont appliquées aux vues orientées lignes.
En production, cette approche réduit considérablement la taille des invites, le coût et la latence d’inférence tout en améliorant la qualité des réponses.
Exemples illustratifs
Nous évaluons l’utilisation des jetons et la qualité des réponses (mesurées par un score de raisonnement LLM en tant que juge) sur des charges de travail représentatives du monde réel. Chaque charge de travail comprend des tâches indépendantes correspondant à des étapes individuelles d’un flux de travail de dépannage. Étant donné que notre évaluation se concentre sur les performances en une seule étape, nous n’incluons pas de trajectoires de diagnostic agentique complètes avec les appels d’outils. En plus de réduire considérablement l’utilisation des jetons, ACE permet également d’obtenir une plus grande précision des réponses.
1. Remplissage des emplacements : les invites du runbook réseau combinent des instructions avec l’état de la carte et du chat codés en JSON, les variables antérieures, les schémas d’outils et l’intention de l’utilisateur. La tâche consiste à faire surface d’une poignée de champs enfouis sous des charges utiles de machines denses et répétitives.
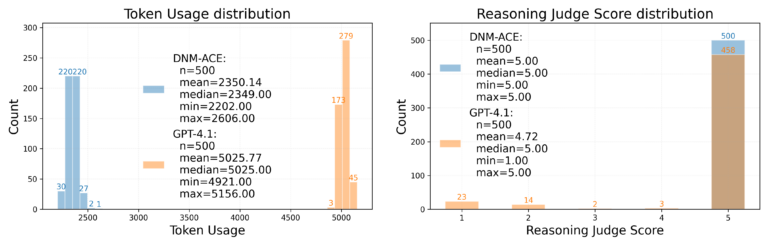
Notre approche réduit le nombre moyen de jetons de 5 025 à 2 350 et corrige 42 erreurs (sur 500 tests) par rapport à l’appel direct de GPT-4.1.
2. Comportements anormaux : la tâche consiste à gérer un large éventail de tâches d’analyse de données machine dans les flux de travail d’observabilité.
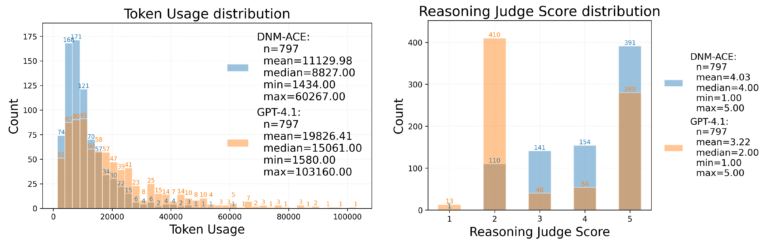
En appliquant des opérateurs de détection d’anomalies aux vues en colonnes pour fournir des informations contextuelles supplémentaires, notre approche augmente le score moyen de qualité des réponses de 3,22 à 4,03 (sur 5,00), soit une augmentation de 25 % de la précision, tout en obtenant une réduction de 44 % de l’utilisation des jetons sur 797 échantillons.
3. Graphique linéaire : l’entrée consiste généralement en des données métriques de séries chronologiques qui sont des tableaux d’enregistrements de mesure collectés à intervalles réguliers. La tâche consiste à restituer ces données à l’aide de bibliothèques de graphiques frontales.
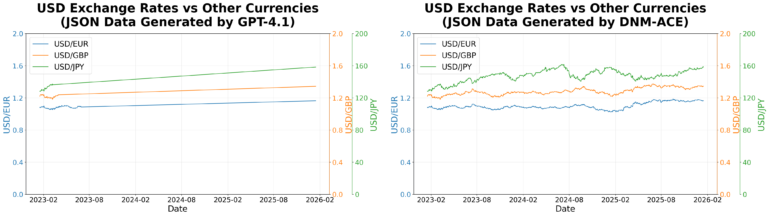
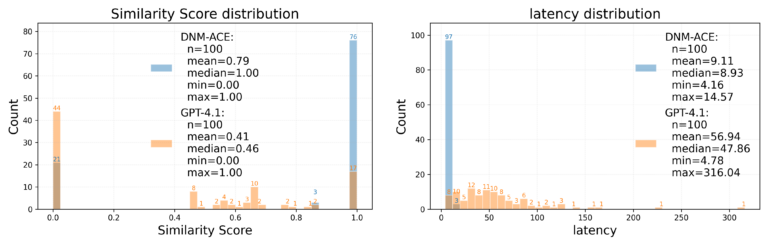
L’appel direct du LLM entraîne souvent un rendu des données incomplet en raison de longues séquences de sortie, même lorsque l’entrée s’inscrit dans la fenêtre contextuelle. Dans la figure ci-dessus, LLM produit un graphique linéaire avec seulement 40 à 120 points par série au lieu des 778 attendus, ce qui entraîne des points de données manquants. Sur 100 échantillons de test, comme le montrent les deux figures suivantes, notre approche permet d’économiser environ 87 % de jetons, réduit la latence moyenne de bout en bout de 47,8 s à 8,9 s et améliore le score de qualité des réponses (similarity_overall) de 0,410 à 0,786 (sur 1,00).
4. Résumé de l’analyse comparative : en plus des trois exemples présentés ci-dessus, nous comparons les indicateurs de performances clés pour un large éventail de tâches liées au réseau dans le tableau suivant.
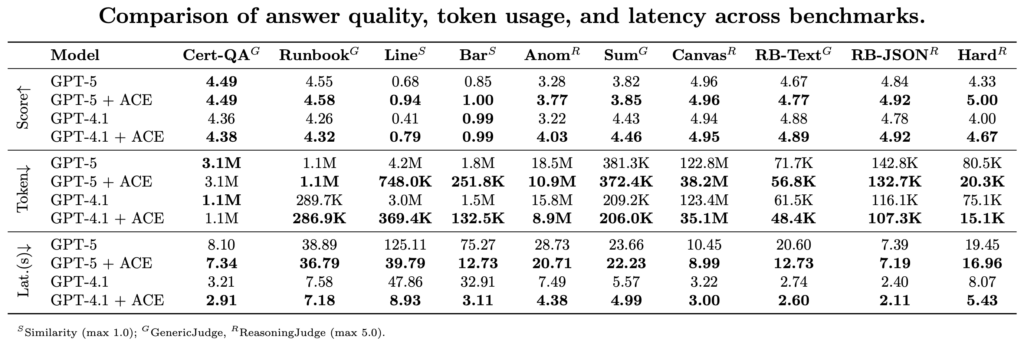
Observations : des tests approfondis sur un large éventail de tests démontrent qu’ACE réduit l’utilisation des jetons de 20 à 90 % en fonction de la tâche, tout en maintenant et, dans de nombreux cas, en améliorant la précision des réponses. En pratique, cela offre effectivement une fenêtre contextuelle « illimitée » pour les invites impliquant des données machine.
L’évaluation ci-dessus ne couvre que les étapes individuelles d’un flux de travail agent. Les principes de conception fondés sur un système de fichiers virtuel et une gestion de base de données permettent à ACE d’interagir avec le processus de raisonnement du LLM en extrayant les signaux saillants du vaste volume de données d’observabilité via des interactions multi-tours.